
Jak sprawić, żeby CV na stronie i CV w PDF-ie nigdy się nie rozjechały?
CV na stronie i trzy pliki PDF (en, pl, es) powstają z jednego pliku TypeScript. Playwright drukuje zaprojektowany arkusz A4, a test łapie każdy rozjazd.
Trzymaj CV jako dane, a nie jako dwa dokumenty. Na tej stronie jeden plik TypeScript zasila stronę /cv/ i zaprojektowany arkusz A4, który Playwright drukuje do PDF-ów po angielsku, polsku i hiszpańsku. Test jednostkowy pada, gdy dane się zmienią, a PDF-ów nikt nie wydrukuje na nowo, więc strona i plik nie mogą po cichu mówić dwóch różnych rzeczy.
TL;DR
- Jeden plik,
src/data/cv.ts, trzyma wszystkie fakty z CV w trzech językach. Czytają go dwa układy:CvSheet.astrona papier iCvWeb.astrona ekran.bun run cv:sheetdrukuje arkusz przezpage.pdf()z Playwrighta, mieści go na dwóch stronach A4 i sprawdza tekst PDF-a, zanim podmieni plik na stronie.- Arkusz niesie skrót (digest) danych, które pokazuje.
cv.test.tspada, gdy dane przestają pasować do PDF-ów.
Skąd w ogóle bierze się rozjazd?
Stąd, że CV zwykle istnieje dwa razy: jako PDF z edytora dokumentów i jako strona przepisana ręcznie. Każdą zmianę trzeba wprowadzić w obu miejscach i prędzej czy później o jednym się zapomina: strona dostaje nową pracę, a PDF zostaje ze starym stanowiskiem. Dorzuć trzy języki i masz sześć kopii.
W wiki mojego projektu jest zasada na jedną linijkę: nigdy nie edytuj samej strony ani samego PDF-a. Zasady trzymają się tylko wtedy, gdy coś ich pilnuje, więc ten układ zamienia rozjazd w czerwony test, a nie w kwestię pamięci.
Co siedzi w pliku z danymi?
cv.ts eksportuje jeden obiekt. Każdy tekst, który zależy od języka, to rekord z osobną wartością dla każdego locale:
export type Text = Record<Locale, string>; // { en, pl, es }

export interface CvEntry {
  id: string;
  title: Text;
  org?: Text | undefined;
  when: Text; // pokazywane tak, jak zapisane: "2026", "Od 2022"
  bullets: Text[];
  links?: { label: string; href: string }[];
  short?: { name: string; note: Text }; // jedna linijka na stronę główną
  current?: boolean; // rola, którą pełnię teraz
  placeholder?: boolean;
}
Dalej idą sekcje, od podsumowania i doświadczenia aż po języki i jednozdaniową klauzulę rekrutacyjną, której oczekują polscy rekruterzy. Wartość, która nie jest jeszcze ostateczna, ma flagę placeholder, a skrypt drukujący ostrzega o niej.
Treść CV to dłuższy tekst, więc siedzi tu osobno dla każdego języka. Krótkie napisy interfejsu, jak nagłówek „Doświadczenie”, przechodzą przez Lingui, jak każda inna etykieta na stronie (dlaczego Lingui, a nie i18next). Z tego pliku czyta nie tylko samo CV:
| Kto czyta | Co bierze |
|---|---|
/<locale>/cv/ |
wszystko, w układzie na ekran |
/<locale>/cv/print/, a z niej PDF-y |
wszystko, na arkuszu A4 |
| Sekcja Kompetencje na stronie głównej | kwalifikacje i oś czasu z linijek short |
| Dane strukturalne osoby (Person) | stanowisko i podsumowanie |
llms.txt |
stanowisko, podsumowanie, lokalizację i języki |
Dlaczego PDF ma własny układ?
Bo papier i ekran mają innych czytelników. Pierwsza wersja renderowała jeden komponent dwa razy: jako plakat na ekran i jako prostą kolumnę na papier. Zastąpiłem ją 8 października 2026 zaprojektowanym arkuszem na dwie strony, a strona dostała własny układ: kopia PDF-a na ekranie byłaby po prostu nudna.
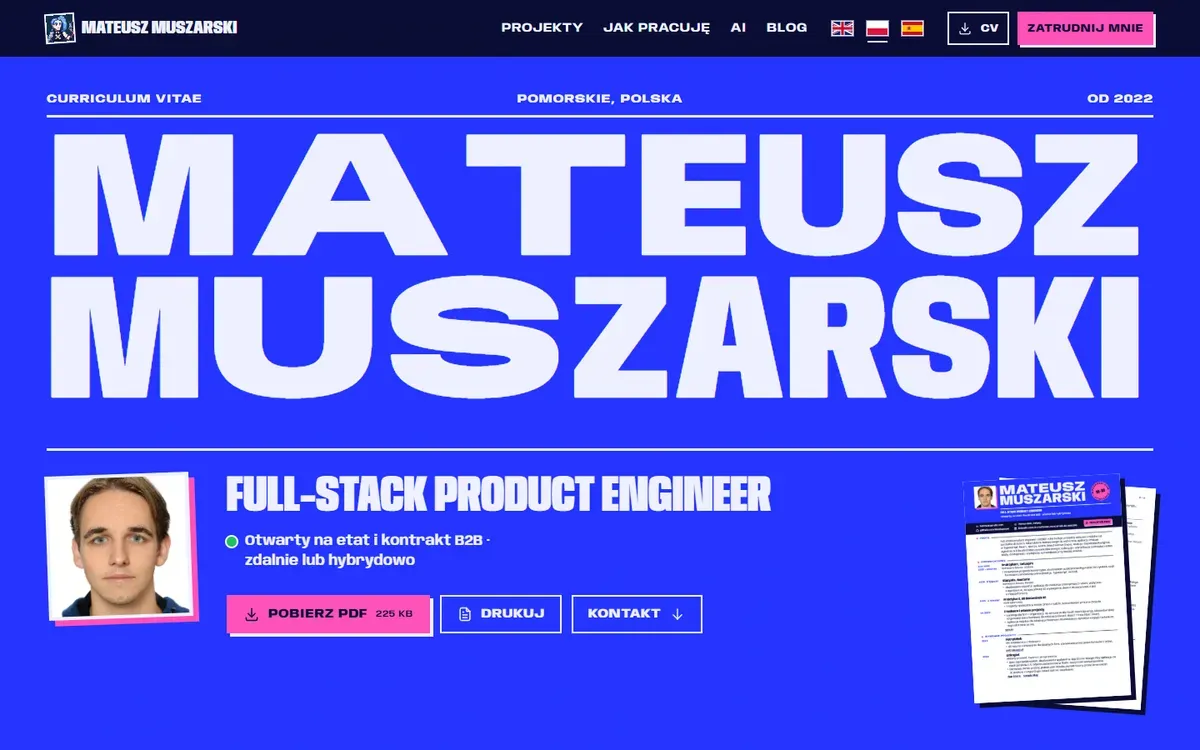 Strona /cv/
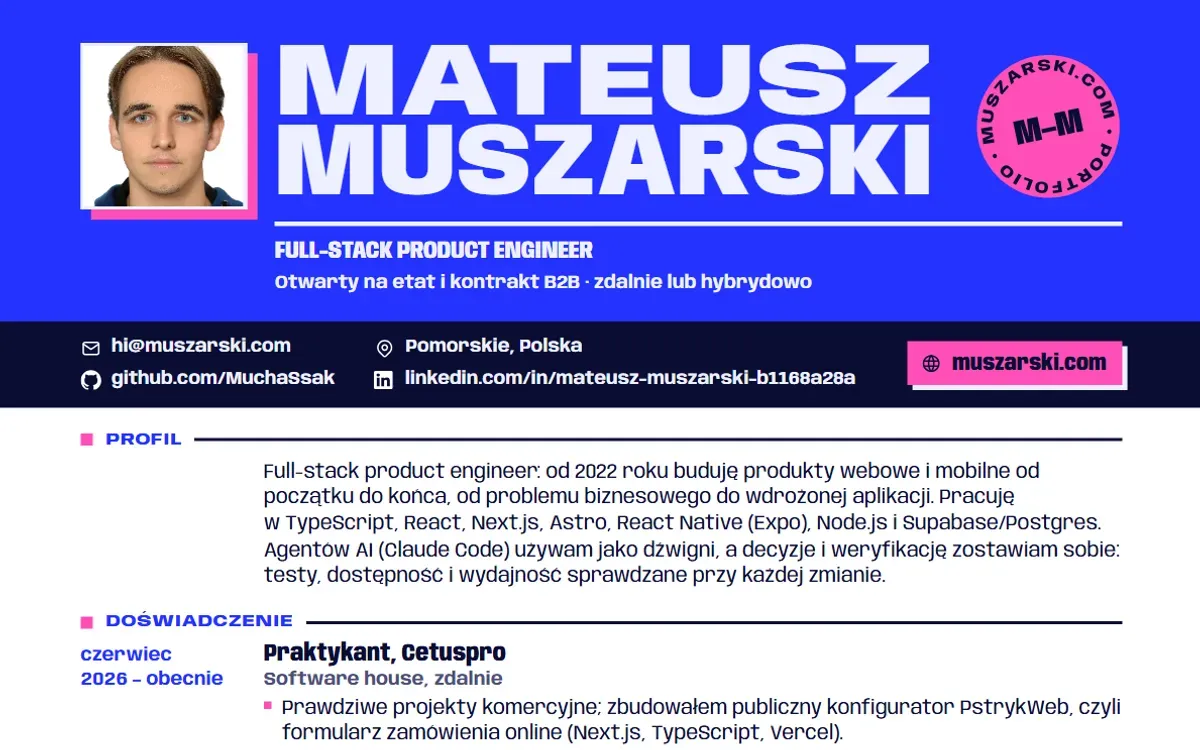 PDF, strona 1
Arkusz obsługuje dwóch czytelników naraz: rekrutera, który z pierwszej strony chce wyczytać, kim jestem, co robię, skąd jestem i jak się ze mną skontaktować, oraz system ATS, który potrzebuje prawdziwego tekstu w kolejności czytania. Ekran zachowuje te same sekcje, kolejność, słowa i linki, a dokłada kolor, prawdziwe media projektów i przyciski kopiowania. Test end-to-end sprawdza, czy polska strona ma sekcje w kolejności z arkusza.
Jak Playwright zamienia arkusz w PDF?
- 01 cv.ts Każdy fakt z CV, raz dla każdego języka.
- 02 Arkusz Trasa do druku renderuje CvSheet.astro.
- 03 Druk Playwright drukuje go i mieści na dwóch stronach A4.
- 04 Kontrole Fonty, kolejność czytania, linki i daty w tekście PDF-a.
- 05 Pliki PDF, podglądy jego stron i skrót danych.
- 06 cv.test.ts Pada, gdy dane zmieniły się od ostatniego druku.
bun run cv:sheet buduje stronę, serwuje ją na wolnym porcie i dla każdego języka drukuje /<locale>/cv/print/, gdy fonty są już na miejscu:
await page.goto(`${base}/${locale}/cv/print/`, { waitUntil: "networkidle" });
await page.evaluate(() => document.fonts.ready);

// --d idzie od 0 (najgęściej) do 1 (najluźniej); czyta go każdy rozmiar i odstęp arkusza
const pdfAt = async (d) => {
  await page.evaluate((v) => document.documentElement.style.setProperty("--d", String(v)), d);
  return page.pdf({ format: "A4", printBackground: true, preferCSSPageSize: true, tagged: true, outline: true });
};
Według dokumentacji Playwrighta page.pdf() renderuje z mediami CSS print i domyślnie bierze format Letter, więc ustawiam A4. preferCSSPageSize daje pierwszeństwo rozmiarowi z @page, printBackground zostawia kobaltowy pas, a tagged i outline dają dostępny PDF z zakładkami.
Czekanie na document.fonts.ready ma znaczenie przy własnym foncie: według MDN ta obietnica rozwiązuje się, gdy fonty są załadowane, a układ gotowy. Potem skrypt szuka binarnie najluźniejszego --d, przy którym arkusz wciąż mieści się na dwóch stronach, a pdf-lib dopisuje tytuł, autora i język.
PDF-y trafiają do repozytorium, do public/files/, bo build wdrożeniowy nie ma przeglądarki, którą mógłby je wydrukować. Patrzyłem też na react-pdf i Typst: dobre narzędzia, ale oba oznaczały opisanie układu drugi raz, czyli dokładnie ten rozjazd, który chciałem usunąć.
Co robi CSS do druku?
Trasa do druku nie ma nawigacji ani ruchu i sama ustawia papier (w uproszczeniu):
@page {
  size: A4;
  margin: 18mm 0 14mm;
}
@page :first {
  margin: 0 0 14mm; /* stronę 1 otwiera kobaltowy pas */
}
:root {
  color-scheme: light;
}
.cs-entry {
  break-inside: avoid;
}
.cs-sec h2 {
  break-after: avoid;
}
Strona 1 nie ma górnego marginesu, więc tekst PDF-a zaczyna się od mojego imienia i nazwiska. Na marginesie strony 2 jest pagina z nazwiskiem i numer strony, narysowane jako kontury, żeby do tekstu nie trafiło drugie nazwisko. Jasny color-scheme nadpisuje ciemny ze strony. Dwie reguły break- trzymają wpis na jednej stronie i nie zostawiają nagłówka samego na dole.
Strona /cv/ ma własny przycisk Drukuj. Wywołuje print(), a blok @media print chowa elementy serwisu i wybiela stronę.
Co się zepsuło przy pierwszym druku?
Każda kontrola w skrypcie istnieje, bo to raz poszło źle:
- Tekst wyszedł w złej kolejności. Chrome zapisuje tekst PDF-a w kolejności malowania, a element pozycjonowany maluje się po treści w normalnym przepływie: pasek kontaktu wylądował przed moim imieniem. Teraz nic, co zawiera tekst, nie jest pozycjonowane ani transformowane.
- Font zmienny wydrukował się jako glify Type 3, z którymi część parserów sobie nie radzi. Arkusz używa statycznych wariantów tego samego kroju, generowanych przez
bun run cv:fonts. - Szeroki odstęp między literami rozbijał słowa. Rozstrzelony nagłówek wychodził z ekstraktora jako „E D U C A T I O N”. Teraz rozstrzelenie to najwyżej 0,05 em.
Dlatego cv:sheet czyta każdy PDF z powrotem przez pdf.js. Odrzuca wydruk, gdy imię nie jest pierwszym tekstem, nagłówek jest nie na swoim miejscu, font nie jest osadzonym TrueType, linku nie da się kliknąć albo data zjeżdża z linii bazowej swojego tytułu. Odrzucony wydruk nigdy nie zastępuje PDF-a na stronie.
Jak test łapie nieaktualny PDF?
Odciskiem palca danych. cvDigestSource(locale) zostawia z obiektu CV tylko teksty danego języka i zamienia je na JSON. Trasa do druku liczy z tego skrót (SHA-256, pierwsze 16 znaków szesnastkowych) i wstawia go do znacznika <meta name="cv-digest">, a skrypt przepisuje tę wartość do cv-digest.json obok PDF-ów. Test liczy skrót od nowa z aktualnych danych:
describe.each(["en", "pl", "es"] as const)("CV PDF (%s)", (locale) => {
  it("was printed from the current CV data", () => {
    const recorded = JSON.parse(readFileSync(new URL("cv-digest.json", files), "utf8")) as Record<string, string>;
    expect(recorded[locale], "run `bun run cv:sheet` (in apps/web)").toBe(digest(locale));
  });

  it("has its page previews for the /cv/ page", () => {
    expect(existsSync(new URL(`mateusz-muszarski-cv-${locale}-p1.webp`, files))).toBe(true);
  });
});
Skrót jest osobny dla każdego języka, więc literówka po hiszpańsku wywala tylko hiszpański test, a komunikat błędu od razu mówi, co zrobić. Obok stoją jeszcze dwa zabezpieczenia: build produkcyjny staje, gdy brakuje któregoś PDF-a, a test end-to-end sprawdza, czy link „Pobierz PDF” na polskiej stronie ma atrybut download i zwraca 200.
Co dostaje osoba, która wchodzi na stronę?
Na /cv/ pierwszy przycisk to PDF, z rozmiarem odczytanym z pliku w czasie builda. To zwykły link z atrybutem download, który według MDN działa tylko dla adresów z tego samego źródła (same-origin): jeszcze jeden powód, żeby pliki leżały na stronie. Przycisk CV w serwisie (nagłówek, pierwsza sekcja, menu, stopka) zaczyna to pobieranie w ramach kliknięcia, a potem otwiera /cv/, które je potwierdza.
Tekst w PDF-ie to prawdziwy tekst: pdftotext na polskim pliku zaczyna od mojego imienia i nazwiska, z kompletem ogonków. Pliki mają tagi i deklarują swój język.
Ograniczenia
- Skrót obejmuje tylko
cv.ts. Po zmianie arkusza, trasy do druku albo nagłówków CV uruchamiambun run cv:sheetręcznie. - Kontrole czytają tekst tak jak parser (pdf.js, pdftotext), ale żadna z nich nie jest prawdziwym systemem ATS.
- Sprawdzają warstwę tekstu, nie wygląd: po każdym druku i tak oglądam podglądy stron.
- Hiszpański tekst powstał z pomocą maszyny i wciąż czeka na przegląd native speakera.
Efekt znajdziesz pod /pl/cv/, o jedno kliknięcie od PDF-a. Imię i nazwisko na górze tej strony ustawia dopasowanie tekstu w czasie builda, a resztę historii strony opisałem w studium przypadku.
Źródła
- page.pdf() (Playwright docs, class Page) (otwiera się w nowej karcie) (dostęp: )
- @page (MDN) (otwiera się w nowej karcie) (dostęp: )
- Printing (MDN, CSS media queries guide) (otwiera się w nowej karcie) (dostęp: )
- break-inside (MDN) (otwiera się w nowej karcie) (dostęp: )
- FontFaceSet: ready property (MDN) (otwiera się w nowej karcie) (dostęp: )
- <a>: the download attribute (MDN) (otwiera się w nowej karcie) (dostęp: )
- react-pdf (otwiera się w nowej karcie) (dostęp: )
- Typst documentation (otwiera się w nowej karcie) (dostęp: )