
LLM wiki: pamięć projektu dla Claude Code, która przetrwa kompaktowanie
Jak sprawiam, że Claude Code nie zapomina: wiki z plików markdown, tabela routingu, plik lekcji i trzy hooki, które wczytują je po kompaktowaniu.
LLM wiki to folder krótkich stron markdown w repozytorium, które agent czyta, zamiast znowu Cię o wszystko pytać. Moje mieszka w .claude/project-info/. CLAUDE.md kieruje każde zadanie do właściwych stron, hooki przywracają te strony i lekcje po każdym kompaktowaniu, a hook Stop nie pozwala zakończyć zmiany w kodzie bez aktualizacji wiki.
TL;DR
- Problem: każda sesja startuje z pustym kontekstem, kompaktowanie gubi szczegóły, a CLAUDE.md na tyle długi, żeby wszystko pomieścić, kosztuje kontekst przy każdym zapytaniu.
- Zestaw: krótkie strony, krótki CLAUDE.md, który kieruje słowa do stron, i trzy hooki: routing każdego promptu, lekcje po kompaktowaniu i blokada końca tury, gdy zmienił się kod, a wiki nie.
- Nawyk: każda poprawka staje się jedną datowaną regułą w
lessons.md, a reguła, która ciągle wraca, zamienia się w test, regułę lintera albo hook.
Dlaczego wiki, a nie dłuższy CLAUDE.md?
Dokumentacja pamięci zaczyna od sedna: każda sesja Claude Code startuje z pustym oknem kontekstu. Długa sesja dokłada drugi kłopot. Kompaktowanie streszcza rozmowę, żeby zwolnić miejsce, a przewodnik po hookach ostrzega, że mogą przy tym zginąć ważne szczegóły. Najpierw znika to, co padło tylko w czacie: jeśli instrukcja zniknęła po kompaktowaniu, to według dokumentacji była podana wyłącznie w rozmowie.
Oczywisty pomysł to CLAUDE.md, który według strony o oknie kontekstu przetrwa kompaktowanie. Tyle że wczytuje się w całości przy każdym zapytaniu, a dokumentacja radzi trzymać go poniżej 200 linii, bo dłuższe pliki zjadają więcej kontekstu i gorzej się ich przestrzega. Importy nie pomagają: importowane pliki też wczytują się na starcie.
Portfolio z tonem marki, systemem projektowym, trzema językami, stronami prawnymi i CV ma faktów na dużo więcej niż 200 linii. Fakty trafiają więc do wiki, a CLAUDE.md staje się jego spisem treści.
Skąd się wziął ten pomysł?
Andrej Karpathy opublikował ten wzorzec w kwietniu 2026 roku jako „idea file” o nazwie llm-wiki (otwiera się w nowej karcie): model językowy stopniowo buduje i utrzymuje trwałe wiki z plików markdown, które stoi między Tobą a surowymi źródłami. Ma trzy warstwy (surowe źródła, wiki i dokument ze schematem, na przykład CLAUDE.md), trzy operacje (ingest, query i lint, czyli dodanie źródła, pytanie i przegląd), katalog index.md i dopisywany na końcu log.md.
Moje wiki stosuje ten sam pomysł do jednego projektu programistycznego zamiast do tematu badawczego. Różnią się trzy rzeczy:
- Surowe źródła to ja, repozytorium i datowane notatki z researchu.
- Wiki steruje agentem, który pisze kod, więc oprócz wiedzy trzyma reguły: zasady współpracy i lekcje.
- Właściwe strony podają hooki. Nie liczę na to, że agent sam pamięta o zajrzeniu do spisu.
Mój log trzyma nawet kształt wpisów z gista, ## [data] obszar | podsumowanie, więc łatwo go przeszukać grepem.
Jak to jest ułożone?
.claude/project-info/
├─ README.md · working-agreement.md · lessons.md
├─ open-questions.md · placeholders.md · log.md
├─ product/   po co i co: brief, wymagania, odbiorcy, ton
├─ content/   co mówi strona: model treści, projekty
├─ site/      struktura, SEO, i18n, analityka
├─ design/    system projektowy, referencje, kryteria jakości, zasoby
├─ tech/      stack, konwencje, po jednej stronie na bibliotekę
├─ legal/     fakty stojące za stronami prawnymi
├─ memory/    zmierzone liczby
└─ research/  surowe datowane notatki (bez routingu)
Poza research/ jest nieco ponad 30 stron, pogrupowanych według pytania, na które odpowiadają: po co, co, jak to jest zorganizowane, jak wygląda, jak jest zbudowane. Pliki z katalogu głównego zostają tam, bo tam szukają ich hooki.
Jakie zasady trzymają wiki w ryzach?
- Jeden właściciel faktu. Każdy fakt mieszka na jednej stronie, a inne do niej linkują. Kopie się rozjeżdżają.
- Fakt ma źródło.
[user]to moja decyzja,[research]wynik researchu,[repo: ścieżka]to, co mówi kod,[assumption]zgadywanie. Zgadywanie się weryfikuje, decyzji nie, a grep po[assumption]daje listę tego, czego jeszcze nie potwierdziłem. - Lepiej „nie wiem” niż zmyślić. Brakujący fakt zapisuję jako Unknown i przenoszę do
open-questions.md: pytanie, co blokuje, kto odpowiada, co domyślnie, jeśli nikt, i status. - Wszystko, co nieprawdziwe, jest w rejestrze. Każdy placeholder ma wiersz w
placeholders.md, a „wypuszczamy na produkcję” oznacza najpierw wyczyszczenie tej listy. - Gęsto, nie długo. Tabele i krótkie punkty, mniej więcej 40-150 linii na stronę. Stronę, którą da się przejrzeć w minutę, ktoś faktycznie przeczyta.
- Kod wygrywa. Gdy strona i kod mówią co innego, poprawiam stronę.
Jak działa mechanika?
- 01 Routing Hook dopasowuje słowa z promptu do tabeli routingu i wskazuje strony.
- 02 Czytanie Claude otwiera te strony, obok lekcji, które wczytała karta sesji.
- 03 Praca Buduje i uruchamia kontrole z faktami przed oczami.
- 04 Log + lekcja Zmieniona strona jest aktualna, log.md dostaje linię, poprawka staje się regułą.
CLAUDE.md jako rozdzielnik
Mój CLAUDE.md ma 76 linii: tabelę routingu, niezmienniki i komendy. Każdy wiersz łączy słowa, których ludzie naprawdę używają w poleceniach, ze stronami do przeczytania:
| Task touches | Read |
| --- | --- |
| Locales, translation, Lingui, Polish, Spanish, language switcher, hreflang, URL prefix, slugs | `.claude/project-info/site/i18n.md` |
| Code style, folders, git, commits, testing bar, do-not list | `.claude/project-info/tech/conventions.md` |
Routing przy każdym prompcie
Hook UserPromptSubmit działa, zanim Claude zobaczy prompt, a jego wynik trafia do kontekstu. Mój porównuje słowa z promptu z każdym wierszem: dokładne trafienie daje 1, liczba mnoga 0,9, wspólny początek z co najmniej pięciu liter 0,6. Każdy wynik dzielę przez pierwiastek z liczby wierszy, w których to słowo występuje, więc słowa obecne wszędzie niewiele znaczą.
Przechodzi najwyżej pięć wierszy. Mały plik JSON mapuje polskie rdzenie słów na słowa z tabeli, więc polskie prompty też trafiają, gdzie trzeba. Tryb testowy hooka:
> przetłumacz stopkę na hiszpański
  1.00  Pages, sitemap, home sections, hero, header, navigation, footer...  [footer]
  1.00  Locales, translation, Lingui, Polish, Spanish, language switcher...  [spanish]
> where did I leave that
  (nothing routed)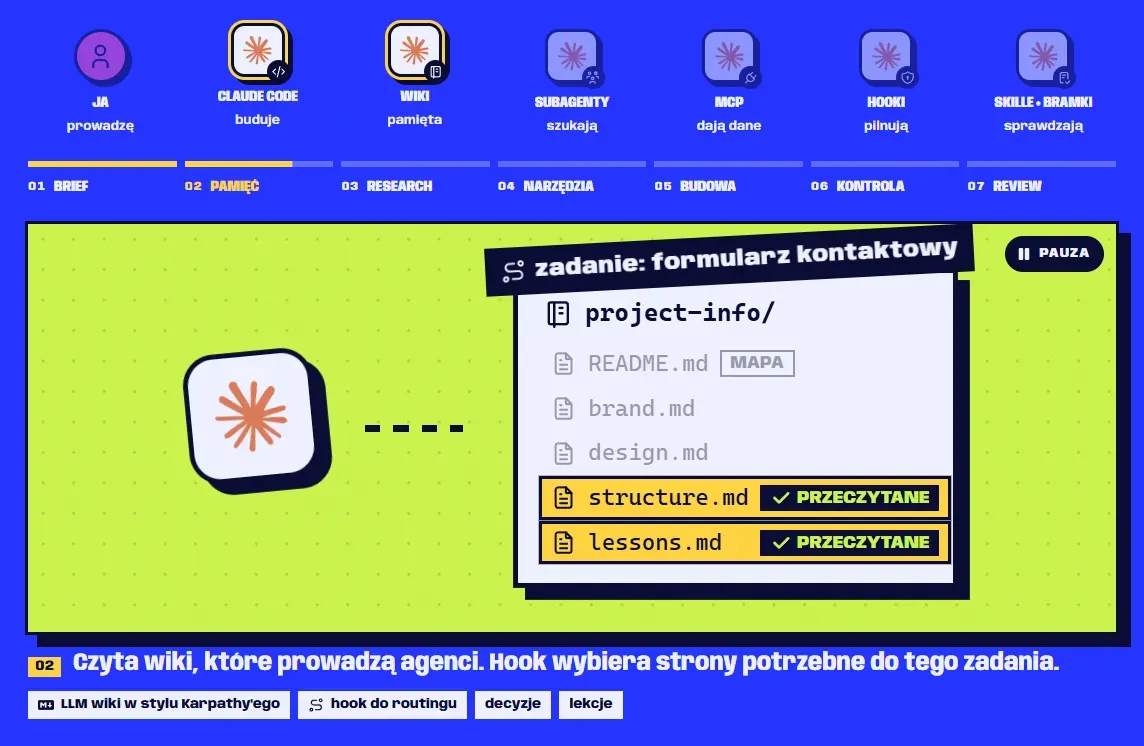
Karta sesji
SessionStart odpala się na starcie, przy wznowieniu, po /clear i po kompaktowaniu, a hook wie, który to przypadek. Przewodnik po hookach zaleca właśnie to: hook SessionStart z matcherem compact, który po każdym kompaktowaniu ponownie wstrzykuje kluczowy kontekst. Mój wypisuje:
- notkę dopasowaną do sytuacji (po kompaktowaniu: to nie jest pauza, kontynuuj bieżące zadanie);
- odnośnik do zasad współpracy;
- stan gita, w samych liczbach;
- sekcję
## Ruleszlessons.md, przyciętą do 8000 znaków.
Kontrola przy końcu odpowiedzi
Kiedy Claude kończy turę, hook Stop porównuje, co zmieniło się w sesji (commity od jej początku plus katalog roboczy), z tym, co zmieniło się w wiki. Zmienił się kod, a wiki nie? Hook blokuje zakończenie jeden raz i podaje kroki: zaktualizuj stronę, dopisz linię do log.md, zapisz lekcję albo napisz, że nic opisanego w wiki się nie zmieniło. Jeśli zmieniło się wiki, uruchamia lint i blokuje przy błędach.
Dokumentacja daje dwa bezpieczniki przed pętlą: pole stop_hook_active i limit kolejnych wznowień z rzędu. Mój skrypt dokłada trzeci: zapamiętuje stan, na którym ostatnio zablokował, więc ten sam diff nigdy nie zablokuje drugi raz.
Jak działa pętla lekcji?
Gdybym miał wyrzucić wszystko poza jednym plikiem, zostawiłbym lessons.md. Kiedy poprawiam Claude'a albo kiedy wyłoży się na jakimś narzędziu, poprawka staje się jedną datowaną linią w trybie rozkazującym, w sekcji ## Rules:
- Git Bash rewrites URL-path arguments (`/en/` → `P:/Git/en/`): prefix with
  `MSYS_NO_PATHCONV=1`, also for `bun run lhci` - 2026-10-05.
Karta sesji wstrzykuje tę sekcję, więc każda sesja i każde kompaktowanie zaczyna się od kompletu reguł. Fakty o produkcie trafiają za to na swoje strony, a zmierzone liczby do memory/. Plik ma się mieścić w 60 regułach i 8000 znakach karty, a reguła, która ciągle wraca, awansuje do automatycznej kontroli (test, reguła lintera, hook), bo to, co wymuszone, działa pewniej niż to, co zapamiętane.
Wbudowane auto memory w Claude Code to co innego: notatki, które Claude pisze sam dla siebie, tylko na jednym komputerze. Ich spis, MEMORY.md, wczytuje się na starcie każdej sesji w pierwszych 200 liniach albo 25 KB. Plik lekcji leży w gicie, więc jego zmiany przeglądam w diffach jak kod.
Jak założyć własne?
- Uruchom
/initalbo napisz krótki CLAUDE.md ręcznie: komendy i zasady nienegocjowalne. - Załóż
.claude/project-info/z pięcioma plikami w katalogu głównym:README.md(mapa),working-agreement.md,lessons.md,open-questions.md,log.md. - Dodawaj strony dopiero wtedy, gdy projekt ich potrzebuje. Narzędzie CLI nie potrzebuje strony o marce.
- Tabelę routingu pisz słowami, których naprawdę używasz, razem z synonimami.
- Hooki dokładaj po kolei: najpierw SessionStart (lekcje po kompaktowaniu), potem routing, na końcu kontrolę przy Stop.
- Przetestuj routing na pięciu realistycznych promptach i jednym „szumie”, który nie powinien trafić nigdzie.
- Każde zadanie kończ tak samo: sprawdź, zaktualizuj stronę, dopisz linię do logu, dodaj lekcję, jeśli ktoś Cię poprawił.
Kroki 2-6 spakowałem w skill, więc nowy projekt startuje z tą samą mechaniką. Przy zakładaniu tego repozytorium test routingu objął 15 promptów, w tym 4 po polsku i jeden szum.
Ograniczenia
- Wiki się rozjeżdża. Jest prawdziwe tylko na tyle, na ile świeża jest ostatnia aktualizacja. Jedno czytanie całości oczami kogoś z zewnątrz, kiedy wiki miało 26 stron, wyłapało około 40 sprzeczności między stronami. Hook Stop dowodzi, że w wiki coś się zmieniło, a nie że to coś jest prawdą.
- Routing się myli. Liczy słowa kluczowe, a nie znaczenie, więc ogólna fraza potrafi przebić stronę, która jest potrzebna. Wspólne słowa zadań wpisuję do każdego wiersza, którego dotyczą, i powtarzam test.
- Kosztuje tokeny i czas. Karta wnosi do każdej sesji do 8000 znaków reguł, a każde zadanie kończy się pracą nad dokumentacją. Nie zmierzyłem, ile to netto oszczędza; wiem tylko, że po kompaktowaniu przestałem się powtarzać.
- To rada, nie przymus. Tak jak CLAUDE.md, wiki to kontekst, a nie konfiguracja. Wszystko, co musi działać zawsze, należy do hooka albo testu.
- Może wyciec. Wiki w gicie to wiki, które ktoś może przeczytać. Podawaj nazwy zmiennych środowiskowych, nigdy wartości. Mój lint szuka w wiki ciągów wyglądających jak klucze.
Jak wiki współpracuje ze skillami, serwerami MCP i subagentami, opisuję we wpisie Skille, hooki, serwery MCP i subagenty w Claude Code. Jeśli dopiero zaczynasz, przyda Ci się Claude Code po polsku, a całą budowę pokazuje studium przypadku. Krok z wiki zobaczysz na żywo w sekcji o AI na stronie głównej, a jeśli chcesz taki proces u siebie w zespole, napisz do mnie.
Źródła
- How Claude remembers your project (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Automate actions with hooks (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Hooks reference (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Explore the context window (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- llm-wiki, plik z pomysłem Andreja Karpathy'ego (GitHub Gist) (otwiera się w nowej karcie) (dostęp: )