
Claude Code po polsku: jak zacząć i pracować z nim na co dzień
Przewodnik dla polskich programistów: instalacja Claude Code, pierwsza sesja, CLAUDE.md, plan, uprawnienia, weryfikacja i uczciwie o kosztach.
Claude Code to narzędzie Anthropic do programowania z agentem: czyta Twój kod, edytuje pliki i uruchamia komendy, w terminalu, w IDE, w aplikacji desktopowej albo w przeglądarce. Na start wystarczy płatny plan albo konto w Claude Console i jedna komenda. Na co dzień liczą się trzy nawyki: krótki CLAUDE.md, plan przed kodem i sprawdzanie każdej zmiany.
TL;DR
- Start: płatny plan albo konto w Claude Console, jedna komenda,
claudew katalogu projektu i kilka pytań o kod, zanim cokolwiek zmienisz.- Na co dzień: krótki CLAUDE.md, tryb planu przed większą zmianą,
/clearmiędzy niezwiązanymi zadaniami i sprawdzanie każdej zmiany testem, buildem albo zrzutem ekranu.- Uczciwie: polskiego nie ma w tabeli wyników wielojęzycznych Anthropic, uprawnienia egzekwuje Claude Code, a nie CLAUDE.md, a koszt zależy od planu, modelu i stylu pracy.
Jak zainstalować Claude Code?
Potrzebujesz płatnego planu (Pro, Max, Team albo Enterprise), konta w Claude Console z przedpłaconymi kredytami API albo dostawcy chmurowego. Darmowego planu na liście w quickstarcie nie ma. 5 października 2026 roku Pro kosztował 20 USD miesięcznie (17 USD przy płatności rocznej), a Max od 100 USD. Ceny się zmieniają, więc sprawdź je przed zakupem.
# macOS, Linux, WSL
curl -fsSL https://claude.ai/install.sh | bash
# Windows PowerShell
irm https://claude.ai/install.ps1 | iexPotem w nowym oknie terminala wpisz claude --version. Jeśli powłoka nie zna tej komendy, katalog instalacji nie trafił do PATH (dokumentacja ma na to osobną stronę). Na Windowsie dokumentacja zaleca Git for Windows, żeby Claude Code mógł korzystać z Basha, a bez niego używa PowerShella. Instalacja natywna aktualizuje się sama, wersje z Homebrew i WinGet trzeba aktualizować ręcznie.
Jak wygląda pierwsza sesja?
cd ~/projekty/moj-projekt
claude
Przy pierwszym uruchomieniu zalogujesz się w przeglądarce. Potem zacznij od pytań, a nie od zmian: „co robi ten projekt?”, „gdzie jest punkt wejścia?”, „wyjaśnij strukturę folderów”. Claude sam czyta potrzebne pliki, więc nie musisz niczego wklejać.
| Komenda | Co robi |
|---|---|
/help |
pokazuje dostępne komendy |
claude -c |
wraca do ostatniej rozmowy w tym katalogu |
claude -r |
pozwala wybrać starszą rozmowę |
/clear |
czyści kontekst między niezwiązanymi zadaniami |
Jak rozmawiać z nim po polsku?
Możesz pisać po polsku od pierwszego promptu. Jeśli chcesz, żeby Claude Code zawsze odpowiadał po polsku, ustaw to w pliku ustawień, na przykład w ~/.claude/settings.json, który działa we wszystkich Twoich projektach:
{
  "language": "polish"
}
Wartość idzie do modelu dosłownie, bez sprawdzania, więc uważaj na literówki.
Uczciwie: polskiego nie ma w tabeli wyników wielojęzycznych, którą publikuje Anthropic. Dokumentacja mówi, że Claude radzi sobie w wielu językach spoza tabeli, i zaleca przetestować te, na których Ci zależy. Radzi też pisać z polskimi znakami, a nie „bez ogonków”.
U mnie kod, commity i dokumentacja są po angielsku, niezależnie od języka rozmowy. Taką decyzję zapisz w CLAUDE.md, żeby nie wracała w każdej sesji.
Co wpisać do CLAUDE.md?
CLAUDE.md to plik, który Claude czyta na starcie każdej sesji. /init wygeneruje pierwszą wersję z kodu, a Ty ją przycinasz. Według dokumentacji warto tam wpisać:
- komendy, których Claude nie zgadnie;
- reguły stylu inne niż domyślne i sposób uruchamiania testów;
- zwyczaje w repozytorium (nazwy gałęzi, pull requesty);
- decyzje architektoniczne, dziwactwa środowiska i nieoczywiste pułapki.
Nie wpisuj tego, co Claude wyczyta z kodu, długich tutoriali ani opisów plik po pliku. Celuj poniżej 200 linii i przy każdej linii zadaj pytanie z dokumentacji: czy bez niej Claude popełniłby błąd? Jeśli nie, wytnij ją.
Dwie rzeczy łatwo przeoczyć. CLAUDE.local.md w katalogu projektu to Twoje prywatne zasady, więc dodaj go do .gitignore. /context pokazuje, czy plik faktycznie się wczytał.
Mój CLAUDE.md ma 76 linii, bo resztę wiedzy trzymam w wiki, opisanym we wpisie LLM wiki: pamięć projektu dla Claude Code.
Dlaczego najpierw plan, a potem kod?
Kuszące jest napisać „zrób mi X” w pierwszym zdaniu. Dokumentacja proponuje cztery kroki:
- 01 Zbadaj Claude czyta kod i odpowiada na pytania, niczego nie zmienia.
- 02 Zaplanuj Plan w trybie planu. Ctrl+G otwiera go w edytorze do poprawek.
- 03 Zaimplementuj Kod według planu, sprawdzony testem albo buildem.
- 04 Zacommituj Commit z opisem, a w razie potrzeby pull request.
Do pierwszych dwóch służy tryb planu: wciskaj Shift+Tab, aż na pasku stanu pojawi się ⏸ plan mode on, albo uruchom claude --permission-mode plan. W tym trybie Claude czyta pliki i odpowiada na pytania, ale nie edytuje źródeł.
Przy większych funkcjach dokumentacja radzi poprosić Claude'a o wywiad z Tobą i spisanie specyfikacji, a implementację zacząć w nowej sesji. Przy drobiazgach plan to zbędny narzut: jeśli diff da się opisać jednym zdaniem, pomiń planowanie. Przy tej stronie cała faza zero była samym planowaniem: research i wiki, zanim powstał kod produktu.
Jak działają uprawnienia?
Claude Code pyta albo nie pyta o zgodę w zależności od trybu. Przełączasz je klawiszem Shift+Tab, a aktualny tryb widać na pasku stanu.
| Tryb | Co robi |
|---|---|
default (Manual) |
bez pytania tylko czyta, pyta przed edycją, komendą i siecią |
acceptEdits |
sam akceptuje edycje plików i proste komendy plikowe |
plan |
czyta i planuje, nie edytuje źródeł |
auto |
bez rutynowych pytań, akcje sprawdza w tle osobny klasyfikator |
dontAsk |
odrzuca wszystko, co wymagałoby pytania, poza wcześniej dozwolonym |
bypassPermissions |
pomija pytania, tylko w odizolowanym kontenerze albo maszynie wirtualnej |
Nowsze wersje startują w terminalu w trybie auto, ale to zależy też od ustawień, więc patrz na pasek stanu. /permissions pokazuje reguły allow, ask i deny, sprawdzane w kolejności deny, ask, allow. I najważniejsze: reguły egzekwuje Claude Code, a nie model. Zakaz w CLAUDE.md wpływa na to, co Claude próbuje zrobić, ale niczego nie blokuje.
Jak dawać mu kontekst?
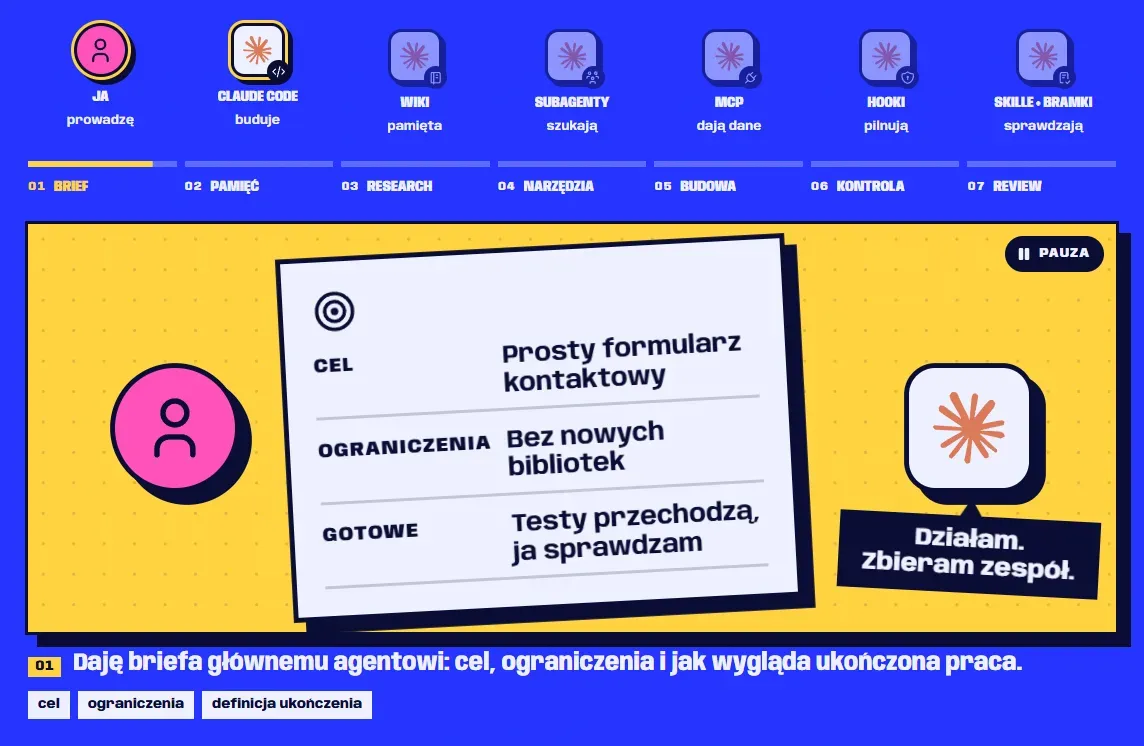
- Konkretnie. Który plik, jaki scenariusz, co znaczy „naprawione”. Zamiast „napraw logowanie” napisz: logowanie pada po wygaśnięciu sesji, sprawdź odświeżanie tokenu w
src/auth/, najpierw napisz test, który odtwarza błąd, potem go napraw. - Z odnośnikami. Wskazuj pliki przez
@, wklejaj zrzuty ekranu, podawaj adresy dokumentacji. - Na wzorcu. Pokaż istniejący fragment kodu, na którym Claude ma się wzorować.
- Dosłownie. Komunikaty błędów wklejaj w całości i proś o przyczynę, a nie o wyciszenie błędu.
- Z terminala. Logi przekażesz bez kopiowania:
cat error.log | claude -p "wyjaśnij ten błąd".
Jak sprawdzać jego pracę?
Dokumentacja ujmuje to krótko: Claude kończy, kiedy praca wygląda na skończoną. Bez sprawdzenia, które da się uruchomić, jedynym sygnałem jest „wygląda dobrze”, a pętlą weryfikacji stajesz się Ty. Daj mu więc coś, co zwraca wynik: testy, kod wyjścia builda, linter, zrzut ekranu do porównania z projektem. Proś o dowody, a nie zapewnienia.
Na tej stronie „gotowe” znaczy: typecheck, lint, testy jednostkowe i e2e. Do tego zrzuty z Playwrighta w szerokościach 390, 1024 i 1920 pikseli, które ktoś faktycznie obejrzał, axe na kontrast AA i ograniczony ruch. Gdy zmiana może ruszyć wynik, mobilny Lighthouse musi dać co najmniej 90.
Inny przykład: na stażu w Neoteric, polskim software housie, zbudowałem samymi agentami AI Clockful, aplikację do ewidencji czasu pracy z rolami. Powstała ze specyfikacji 15 wymagań w około 9 dni (to szacunek z dat w repozytorium), a pilnowały jej testy automatyczne w Vitest i Playwright.
Jakie błędy zdarzają się najczęściej?
Dokumentacja wymienia pięć typowych wzorców porażki:
- Sesja „wszystko w jednym”. Jedno zadanie, potem coś obok, potem powrót. Rozwiązanie:
/clearmiędzy niezwiązanymi zadaniami. - Poprawianie w kółko. Po dwóch nieudanych poprawkach zrób
/cleari napisz lepszy pierwszy prompt z tym, czego się nauczyłeś. - Przeładowany CLAUDE.md. Ważne zasady giną w szumie. Przycinaj bez litości.
- Zaufanie bez sprawdzenia. Kod wygląda wiarygodnie, a gubi przypadki brzegowe. Czego nie da się sprawdzić, tego nie wdrażaj.
- Niekończące się badanie. „Zbadaj X” bez zakresu kończy się setkami przeczytanych plików. Zawęź pytanie albo oddaj je subagentowi.
Do tego dwa narzędzia ratunkowe. Esc zatrzymuje Claude'a w trakcie, a podwójne Esc albo /rewind cofa rozmowę, kod albo jedno i drugie do punktu kontrolnego. Punkty kontrolne śledzą tylko zmiany zrobione narzędziami edycji Claude'a, a nie komendami w Bashu, więc nie zastępują gita.
I jeszcze jeden błąd, przez który napisałem sobie osobny hook: ustalenia podane tylko w czacie znikają po kompaktowaniu. Co ma przetrwać, zapisuj w CLAUDE.md albo w pliku, który wczyta hook.
Ile to kosztuje?
- Kontekst to główny zasób. Jakość pracy modelu spada, gdy okno kontekstu się zapełnia. Stąd
/clear, subagenty do researchu i krótki CLAUDE.md. - Limity. W planach subskrypcyjnych użycie jest wliczone w plan z limitami, a
/usagepokazuje, ile już zużyłeś. Subagenty też go zużywają. - Punkt odniesienia. We wdrożeniach firmowych średni koszt to według dokumentacji około 13 USD na programistę na aktywny dzień i 150-250 USD miesięcznie, a u 90% użytkowników poniżej 30 USD dziennie. To dane z firm rozliczanych za API, a nie cena Twojego planu.
- Jak płacić mniej. Czyść kontekst między zadaniami, prostsze zadania dawaj tańszemu modelowi (
/model), wyłącz nieużywane serwery MCP.
Ograniczenia
- Bez moich rachunków. Zależą od planu, modelu i stylu pracy, więc niewiele powiedziałyby o Twoich.
- Bez pomiaru polskiego. Nie mierzyłem jakości odpowiedzi po polsku; wszystko o języku biorę z dokumentacji.
- Stan na październik 2026. Ceny sprawdziłem 5 października, tryby uprawnień i koszty 8 października. Claude Code zmienia się szybko, więc przed decyzją zajrzyj do źródeł.
Od czego zacząć jutro?
- Zainstaluj, zaloguj się, otwórz mały projekt.
- Zadaj trzy pytania o kod, zanim cokolwiek zmienisz.
- Uruchom
/initi przytnij wynik do tego, czego Claude nie wyczyta z kodu. - Pierwszą zmianę zrób w trybie planu, z testem, który Claude ma uruchomić.
- Każdą poprawkę, którą powtarzasz drugi raz, wpisz do CLAUDE.md.
Gdy to wejdzie w nawyk, przyjdzie pora na skille, hooki i serwery MCP: kiedy który, opisuję we wpisie Skille, hooki, serwery MCP i subagenty w Claude Code. Cały ten proces krok po kroku pokazuje sekcja o AI na stronie głównej i studium przypadku. A jeśli szukasz kogoś, kto tak pracuje, zajrzyj do mojego CV.
Źródła
- Overview (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Quickstart (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- How Claude remembers your project (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Best practices for Claude Code (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Choose a permission mode (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Configure permissions (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- All settings: language (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Manage costs effectively (dokumentacja Claude Code) (otwiera się w nowej karcie) (dostęp: )
- Multilingual support (dokumentacja Claude Platform) (otwiera się w nowej karcie) (dostęp: )
- Plans & Pricing (Claude) (otwiera się w nowej karcie) (dostęp: )